vServer-Paket
ZAP Spark
7,29 €/ 30 Tage
- 4 GB RAM
- 2 CPU
- 60 GB NVMe
- 1 Gbit/s Uplink
Du entscheidest, welche Dienste wir zur Analyse, Personalisierung und für externe Inhalte aktivieren dürfen.
Wir verwenden Cookies und ähnliche Technologien auf unserer Website, um Inhalte zu personalisieren, externe Medien einzubinden und die Nutzung einzelner Bereiche besser zu verstehen.
Notwendige Cookies
Diese Einträge sichern Grundfunktionen wie Sicherheit, Stabilität und Formularverarbeitung.
Optionale Bereiche
Die Datenverarbeitung kann mit deiner Einwilligung oder auf Basis berechtigter Interessen erfolgen. In den Cookie-Einstellungen kannst du jeder optionalen Kategorie widersprechen oder sie gezielt freigeben.
Einige Services verarbeiten personenbezogene Daten in Drittländern. Mit deiner Einwilligung akzeptierst du auch diese Übermittlung. Weitere Informationen findest du in unserer Datenschutzerklärung.
Deine Auswahl kann später jederzeit erneut geöffnet und angepasst werden. · 1.0.2
 Open-Source-AI-Gateway auf eigenem vServer
Ein API-Key für 100+ KI-Anbieter: 1-Klick via Coolify, Root-Zugriff, NVMe, DDoS-Schutz, Standorte in Europa & Amerika – ohne GPU.
Pakete 1–3 von 9
LitellmSelbst konfigurieren
Kein Paket passt? Wähle CPU, RAM und Speicher frei – du zahlst nur für das, was dein Projekt wirklich braucht.
Leistungsstarke CPUs
100 Gbit/s Host-Netz
Juniper Firewall
DDoS-Schutz
 Visa
 Mastercard
 American Express
 PayPal
 Google Pay
 Apple Pay
 Klarna
 Amazon Pay
Ein Endpunkt für alle Modelle
Dein Team nutzt Claude im Editor, GPT im Chat und ein lokales Modell für interne Daten – und jedes Tool braucht eigene Keys. LiteLLM bündelt das: Es stellt eine OpenAI-kompatible API bereit und leitet Anfragen an über 100 KI-Anbieter weiter, inklusive deiner Ollama-Instanz. Auf dem ZAP vServer installierst du den LiteLLM-Proxy per 1-Klick über One-Click Apps (Coolify). Eine GPU brauchst du dafür nicht, denn gerechnet wird beim Anbieter.
Weil LiteLLM auf deinem eigenen vServer läuft, bleiben Provider-Keys, Virtual Keys und Logs in deiner Instanz. Du vergibst Budgets pro Person oder Projekt, pinnst die Version, die zu deinen Tools passt, und prüfst Config und Container bei Bedarf selbst per SSH mit Root-Zugriff. Coolify übernimmt Container, Umgebungsvariablen, Domain und HTTPS, sodass du LiteLLM selbst hostest, ohne eine eigene Docker-Compose-Datei zu pflegen.
Funktionen für Entwickler und Teams
Virtual Keys mit Budgets, Spend Tracking pro Team und automatische Fallbacks – verwaltet in der LiteLLM-Admin-UI auf deinem eigenen vServer.
Deine Tools sprechen nur einen Endpunkt im OpenAI-Format – LiteLLM übersetzt für jeden Anbieter.
Fällt ein Modell aus oder drosselt, laufen Anfragen automatisch über ein gesundes Ersatzmodell.
Dein Team bekommt eigene Keys, die echten Provider-Keys bleiben sicher auf dem Server.
Du verfolgst Aufrufe vom Tool über den Key bis zum Anbieter – samt Tokens und Status.
Du siehst pro Key und Team, was anfällt, und stoppst Ausreißer per Budgetgrenze.
Neue Keys und Modelle prüfst du mit einem Test-Request, bevor dein Team sie nutzt.
Standorte in Europa und Amerika
4 Rechenzentren in Europa und Amerika — wähle den Standort, der am nächsten zu deinen Nutzern liegt.

LiteLLM im Detail
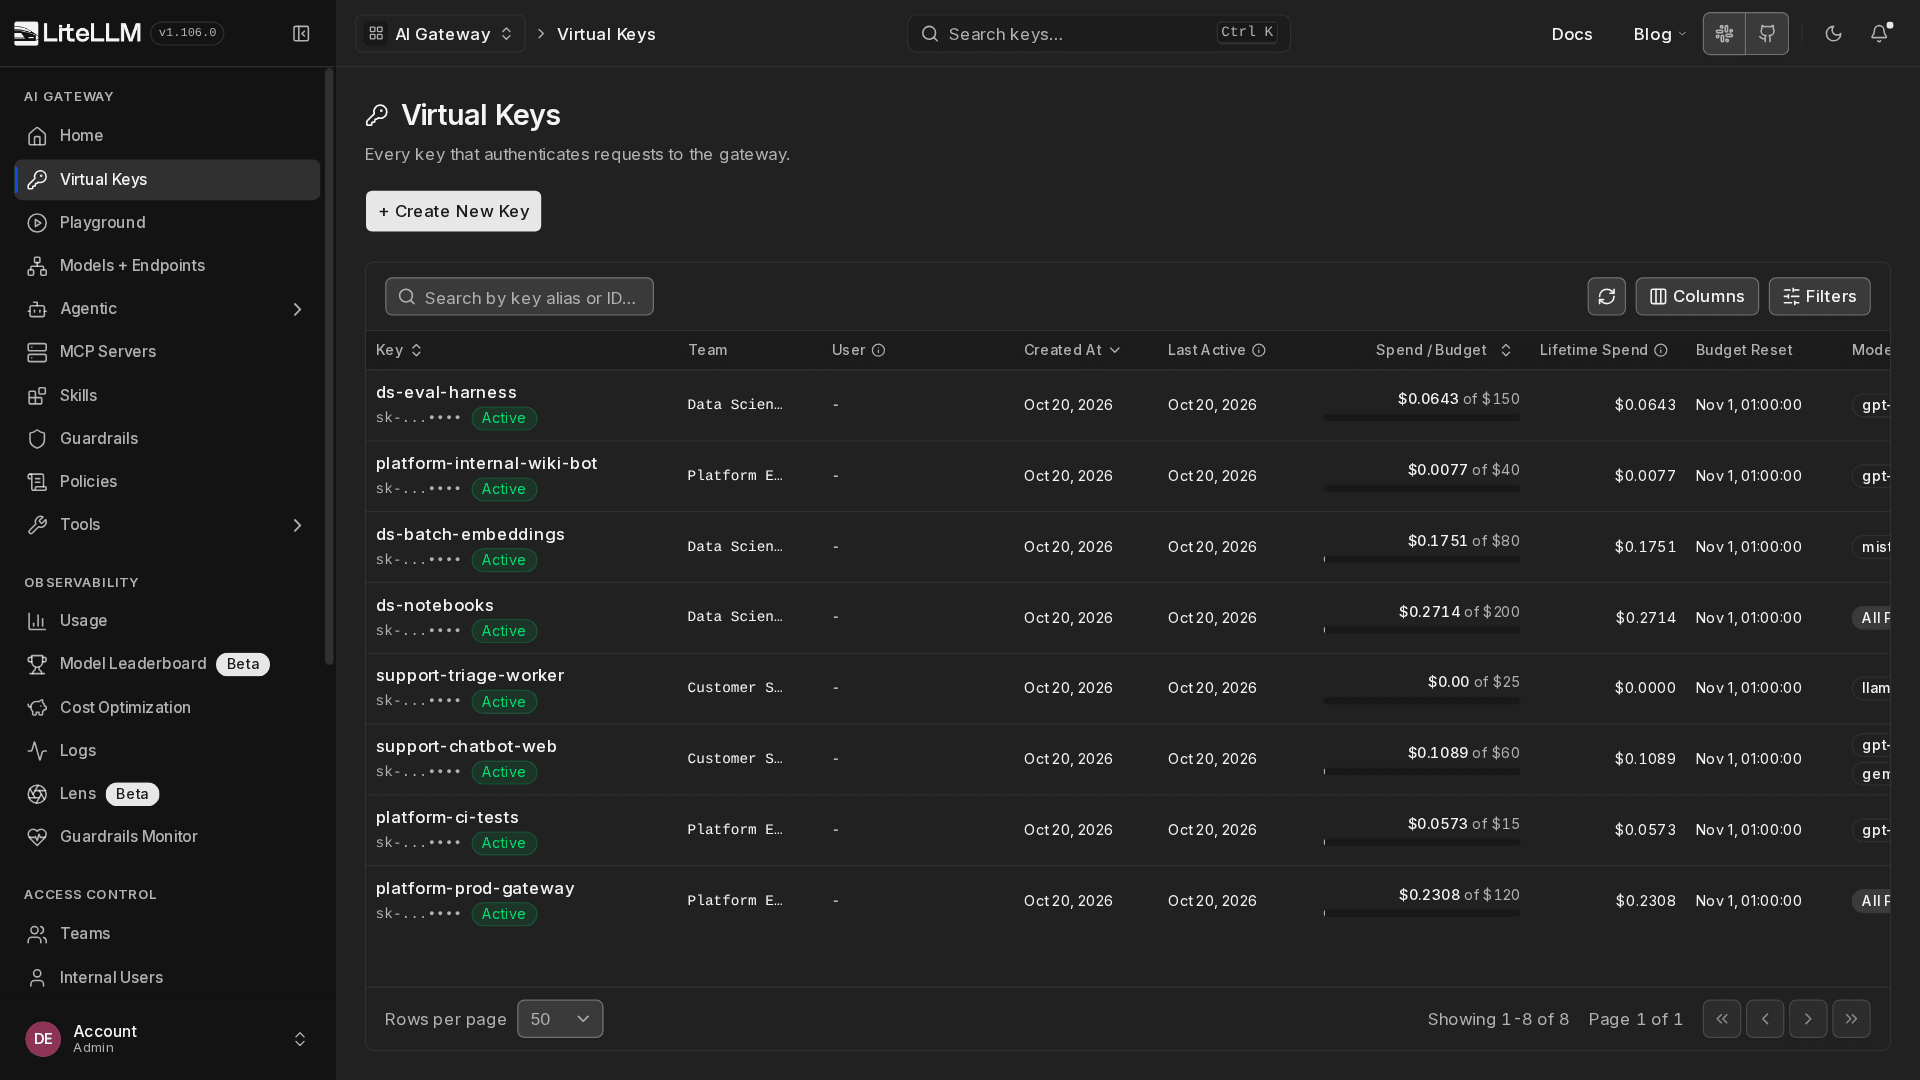
Von der Key-Verwaltung über Load Balancing bis Spend Tracking: LiteLLM macht aus vielen KI-Anbietern einen kontrollierten Endpunkt – mit Request-Logs und Fehlerübersicht.
Litellm
Litellm
Key-Verwaltung für alle Anbieter
Alle Provider-Keys und Virtual Keys liegen übersichtlich in einer Liste: maskiert angezeigt, nach Anbieter sortiert und per Schalter aktivierbar. So sperrst du einen kompromittierten Key in Sekunden, ohne Tools neu konfigurieren zu müssen.
Jetzt starten
Litellm in wenigen Minuten auf deinem vServer — ohne komplizierte Einrichtung.
Backups & Snapshots
Snapshots bringen dich schnell zurück. Mit ZapX Pass schaltest du Restore, manuelle Backups und längere Aufbewahrung der Tagesbackups frei.
Mehr Kontrolle mit ZapX Passmehr Speicher, Restore, Pass-Vorteile und Lifetime-vServer ohne Aktivitätschecks
Bewertungen
Echtes Feedback zu Support und Setup.
Ich möchte an dieser Stelle einfach einmal ein riesengroßes DANKESCHÖN an das gesamte ZAP-Hosting-Team aussprechen! Als langjähriger Kunde mit zahlreichen heißgeliebten Lifetime-Produkten war mir eines immer bewusst: Ein Lifetime-Modell ist für einen Hosting-Anbieter langfristig eine enorme Herausforderung. Server verursachen laufende Kosten, Hardware muss gewartet und erneuert werden, Strom, Infrastruktur und Personal müssen bezahlt werden. Und all das über viele Jahre hinweg. Dass bei einer großen Anzahl an Lifetime-Kunden irgendwann eine nachhaltige Lösung gefunden werden muss, war für mich daher absolut nachvollziehbar. Und genau hier hat ZAP-Hosting mit ZAPX meiner Meinung nach etwas wirklich Großartiges geschaffen! Anstatt einfach aufzugeben, bestehende Lifetime-Angebote einzustellen oder die Kunden im Regen stehen zu lassen, hat man sich Gedanken gemacht, investiert und ein modernes Konzept entwickelt, das eine langfristige Perspektive für unsere Lifetime-Server schaffen soll. Das ist für mich keine Selbstverständlichkeit, sondern verdient großen Respekt! Natürlich kostet die neue Lösung etwas. Aber ganz ehrlich: Niemand sollte vergessen, welchen enormen Gegenwert wir hier erhalten! Für einen vergleichsweise kleinen Betrag bekommen wir die Möglichkeit, unsere geliebten Lifetime-Server weiterhin zu nutzen und gleichzeitig von einer modernen Plattform zu profitieren. Für mich ist das Angebot seinen Preis mehr als wert – gefühlt sogar tausendmal mehr! Und dann wäre da noch das neue ZAPX-Panel ... Was soll ich sagen? Ein absoluter Augenschmaus! 😍 Modern, wunderschön gestaltet, übersichtlich und einfach ein riesiger Schritt in die Zukunft. Nicht nur ich bin vom neuen Design begeistert, sondern auch meine Freunde. Da bekommen unsere Augen regelrecht Wellness! 😁 Man merkt, dass hier nicht einfach nur ein neues Verwaltungspanel hingestellt wurde, sondern dass sich jemand wirklich Gedanken über Design, Benutzerfreundlichkeit und die Zukunft der Plattform gemacht hat. Mein größter Dank gilt aber der Entscheidung, die Lifetime-Kunden nicht einfach aufzugeben. ZAP-Hosting hätte auch einen anderen Weg einschlagen können. Stattdessen versucht man, eine wirtschaftlich tragfähige Lösung zu schaffen, mit der sowohl das Unternehmen als auch wir Kunden langfristig profitieren können. Genau diese Denkweise verdient Anerkennung und Unterstützung! Ich hoffe sehr, dass ZAP-Hosting diesen Weg konsequent weitergeht und wir unsere Lifetime-Produkte noch viele, viele Jahre genießen dürfen. Danke an das gesamte ZAP-Hosting-Team – für eure Arbeit, eure Investitionen, eure Innovationsbereitschaft und vor allem dafür, dass ihr unsere Lifetime-Server nicht vergessen habt! Von mir gibt es dafür 5 verdiente Sterne! ⭐⭐⭐⭐⭐ Macht weiter so! 🚀💚

Bislang sehr zufrieden. Kauf, Einrichtung und Nutzung eines VPS sehr schnell.
 ZAP-HostingAntwort
Ich möchte meine ursprüngliche negative Bewertung ausdrücklich korrigieren und meine inzwischen sehr positive Erfahrung mit ZAP-Hosting teilen. Im Juni 2026 wurde mein Lifetime-Server aufgrund der geltenden Inaktivitätsregel deaktiviert. Mir war zu diesem Zeitpunkt nicht bewusst, dass ich mich mindestens alle drei Monate einloggen muss, um den Server aktiv zu halten. An dieser Stelle möchte ich ausdrücklich betonen, dass der Fehler bei mir lag und nicht bei ZAP-Hosting. Die Inaktivitätsregel ist in den AGB klar geregelt, und ich hatte diese schlichtweg übersehen. Nachdem ich mich an den Support gewandt und die Situation geschildert hatte, zeigte sich ZAP-Hosting äußerst verständnisvoll und kulant. Obwohl das Unternehmen hierzu nicht verpflichtet war, wurde mir aus Kulanz ein neuer Lifetime-Server als Ersatz zur Verfügung gestellt. Das ist für mich alles andere als selbstverständlich und zeigt, dass bei ZAP-Hosting nicht nur auf Vertragsbedingungen geachtet wird, sondern auch auf Kundenzufriedenheit und faire Lösungen. Meine damalige negative Bewertung habe ich inzwischen löschen lassen, da sie meiner heutigen Erfahrung mit dem Unternehmen nicht mehr gerecht wird. Ich möchte mich ausdrücklich beim gesamten ZAP-Hosting-Team für das Entgegenkommen und die kundenfreundliche Lösung bedanken. Ein solches Verhalten verdient Anerkennung und eine klare Weiterempfehlung. Vielen Dank, ZAP-Hosting!
 ZAP-HostingAntwort
Die Minecraft Server haben eine Gute Leistung, wir bezahlen z.B 1,61€ pro Person jeden Monat, und der Server läuft echt gut, vor allem die Chunks laden gut
 ZAP-HostingAntwort
Bin sehr zufrieden mit Zap Hosting. Die Server laufen Einwandfrei und Stabil. Einziges Manko ist das die SSDs zum Teil ein bisschen langsam sind. Aber ansonsten Top 👍
ZAP-HostingAntwortIch bin mit meinem Webspace bei ZAP-Hosting sehr zufrieden. Die Einrichtung war unkompliziert und alles läuft bisher stabil und zuverlässig. Die Ladezeiten sind gut und die Verwaltung ist übersichtlich gestaltet. Auch das Preis-Leistungs-Verhältnis finde ich überzeugend. Insgesamt habe ich bisher sehr gute Erfahrungen gemacht und kann ZAP-Hosting für Webspace definitiv weiterempfehlen! ⭐⭐⭐⭐⭐

FAQ
Antworten auf die wichtigsten Fragen vor dem Start.
Über One-Click Apps: Du bestellst den vServer, öffnest die App-Übersicht mit Coolify und installierst LiteLLM per 1-Klick. Coolify startet den Proxy als Docker-Container samt PostgreSQL und verbindet Domain und HTTPS. Danach trägst du in der Admin-UI Provider-Keys und Modelle ein und erstellst Virtual Keys. Neue Versionen spielst du per Redeploy in Coolify ein. Mehr dazu im Help Center
Nein. LiteLLM ist ein Proxy: Er nimmt Anfragen entgegen, prüft Keys und Budgets und leitet sie an den passenden Anbieter weiter. Die eigentliche Rechenarbeit erledigen OpenAI, Anthropic, Mistral & Co. oder eine separate Ollama-Instanz. Für LiteLLM selbst reicht deshalb ein normaler vServer mit CPU, RAM und NVMe-Speicher.
LiteLLM routet nur und rechnet keine Modelle, deshalb zählen CPU, RAM und NVMe-Speicher statt GPU. Wie viel du brauchst, hängt von parallelen Requests, dem Umfang der Spend Logs in der Datenbank und weiteren Apps wie Open WebUI auf demselben Server ab. Für ein kleines Team reicht oft ein Einstiegspaket; wächst die Last, wechselst du auf ein größeres vServer-Paket.
Die Open-Source-Version von LiteLLM ist kostenlos. Bei ZAP-Hosting zahlst du nur deinen vServer – flexible Laufzeit und jederzeit kündbar, die Kündigung greift zum Ende der gebuchten Laufzeit. Die Token-Kosten rechnen OpenAI, Anthropic und andere Anbieter weiter direkt mit dir ab, und Spend Tracking zeigt dir, wer wie viel verbraucht.
Ja. In LiteLLM erstellst du Virtual Keys pro Person, Team oder Projekt und legst dafür Budgets, Rate Limits und erlaubte Modelle fest. Deine echten Provider-Keys bleiben auf dem Server und landen nicht in Editoren, Skripten oder Chat-Tools. Über Spend Tracking siehst du in der Admin-UI, welcher Key welche Kosten verursacht.
Setze einen starken Master Key und gib Admin-UI und API nur über deine Domain mit HTTPS frei. In der Firewall öffnest du nur, was der Coolify-Proxy braucht, und per SSH prüfst du Config und Container selbst. Pinne die Image-Version und lies den Changelog vor jedem Update. Provider-Keys, Virtual Keys und Logs bleiben in deiner Instanz; für Prompts gelten zusätzlich die Bedingungen der KI-Anbieter, die du einträgst. Sicherheitstipps im Help Center
Ja. Du zeigst Claude Code oder OpenCode per Base-URL auf deinen LiteLLM-Proxy und meldest sie mit einem eigenen Virtual Key an. Budget, Rate Limit und erlaubte Modelle legst du pro Key fest, deine Provider-Keys bleiben auf dem Server. Ollama trägst du als weiteres Modell mit seiner API-URL ein, sodass lokale und Cloud-Modelle über denselben Endpunkt laufen.
Du wählst zwischen Standorten in Europa und Amerika. Nimm den, der nah an deinem Team und deinen Anwendungen liegt, denn dann laufen die Requests zwischen deinen Tools und dem Proxy auf kurzem Weg. Viele Teams aus Deutschland starten mit FFM/Eygelshoven.
Noch weitere Fragen?
Support kontaktierenZapX Panel
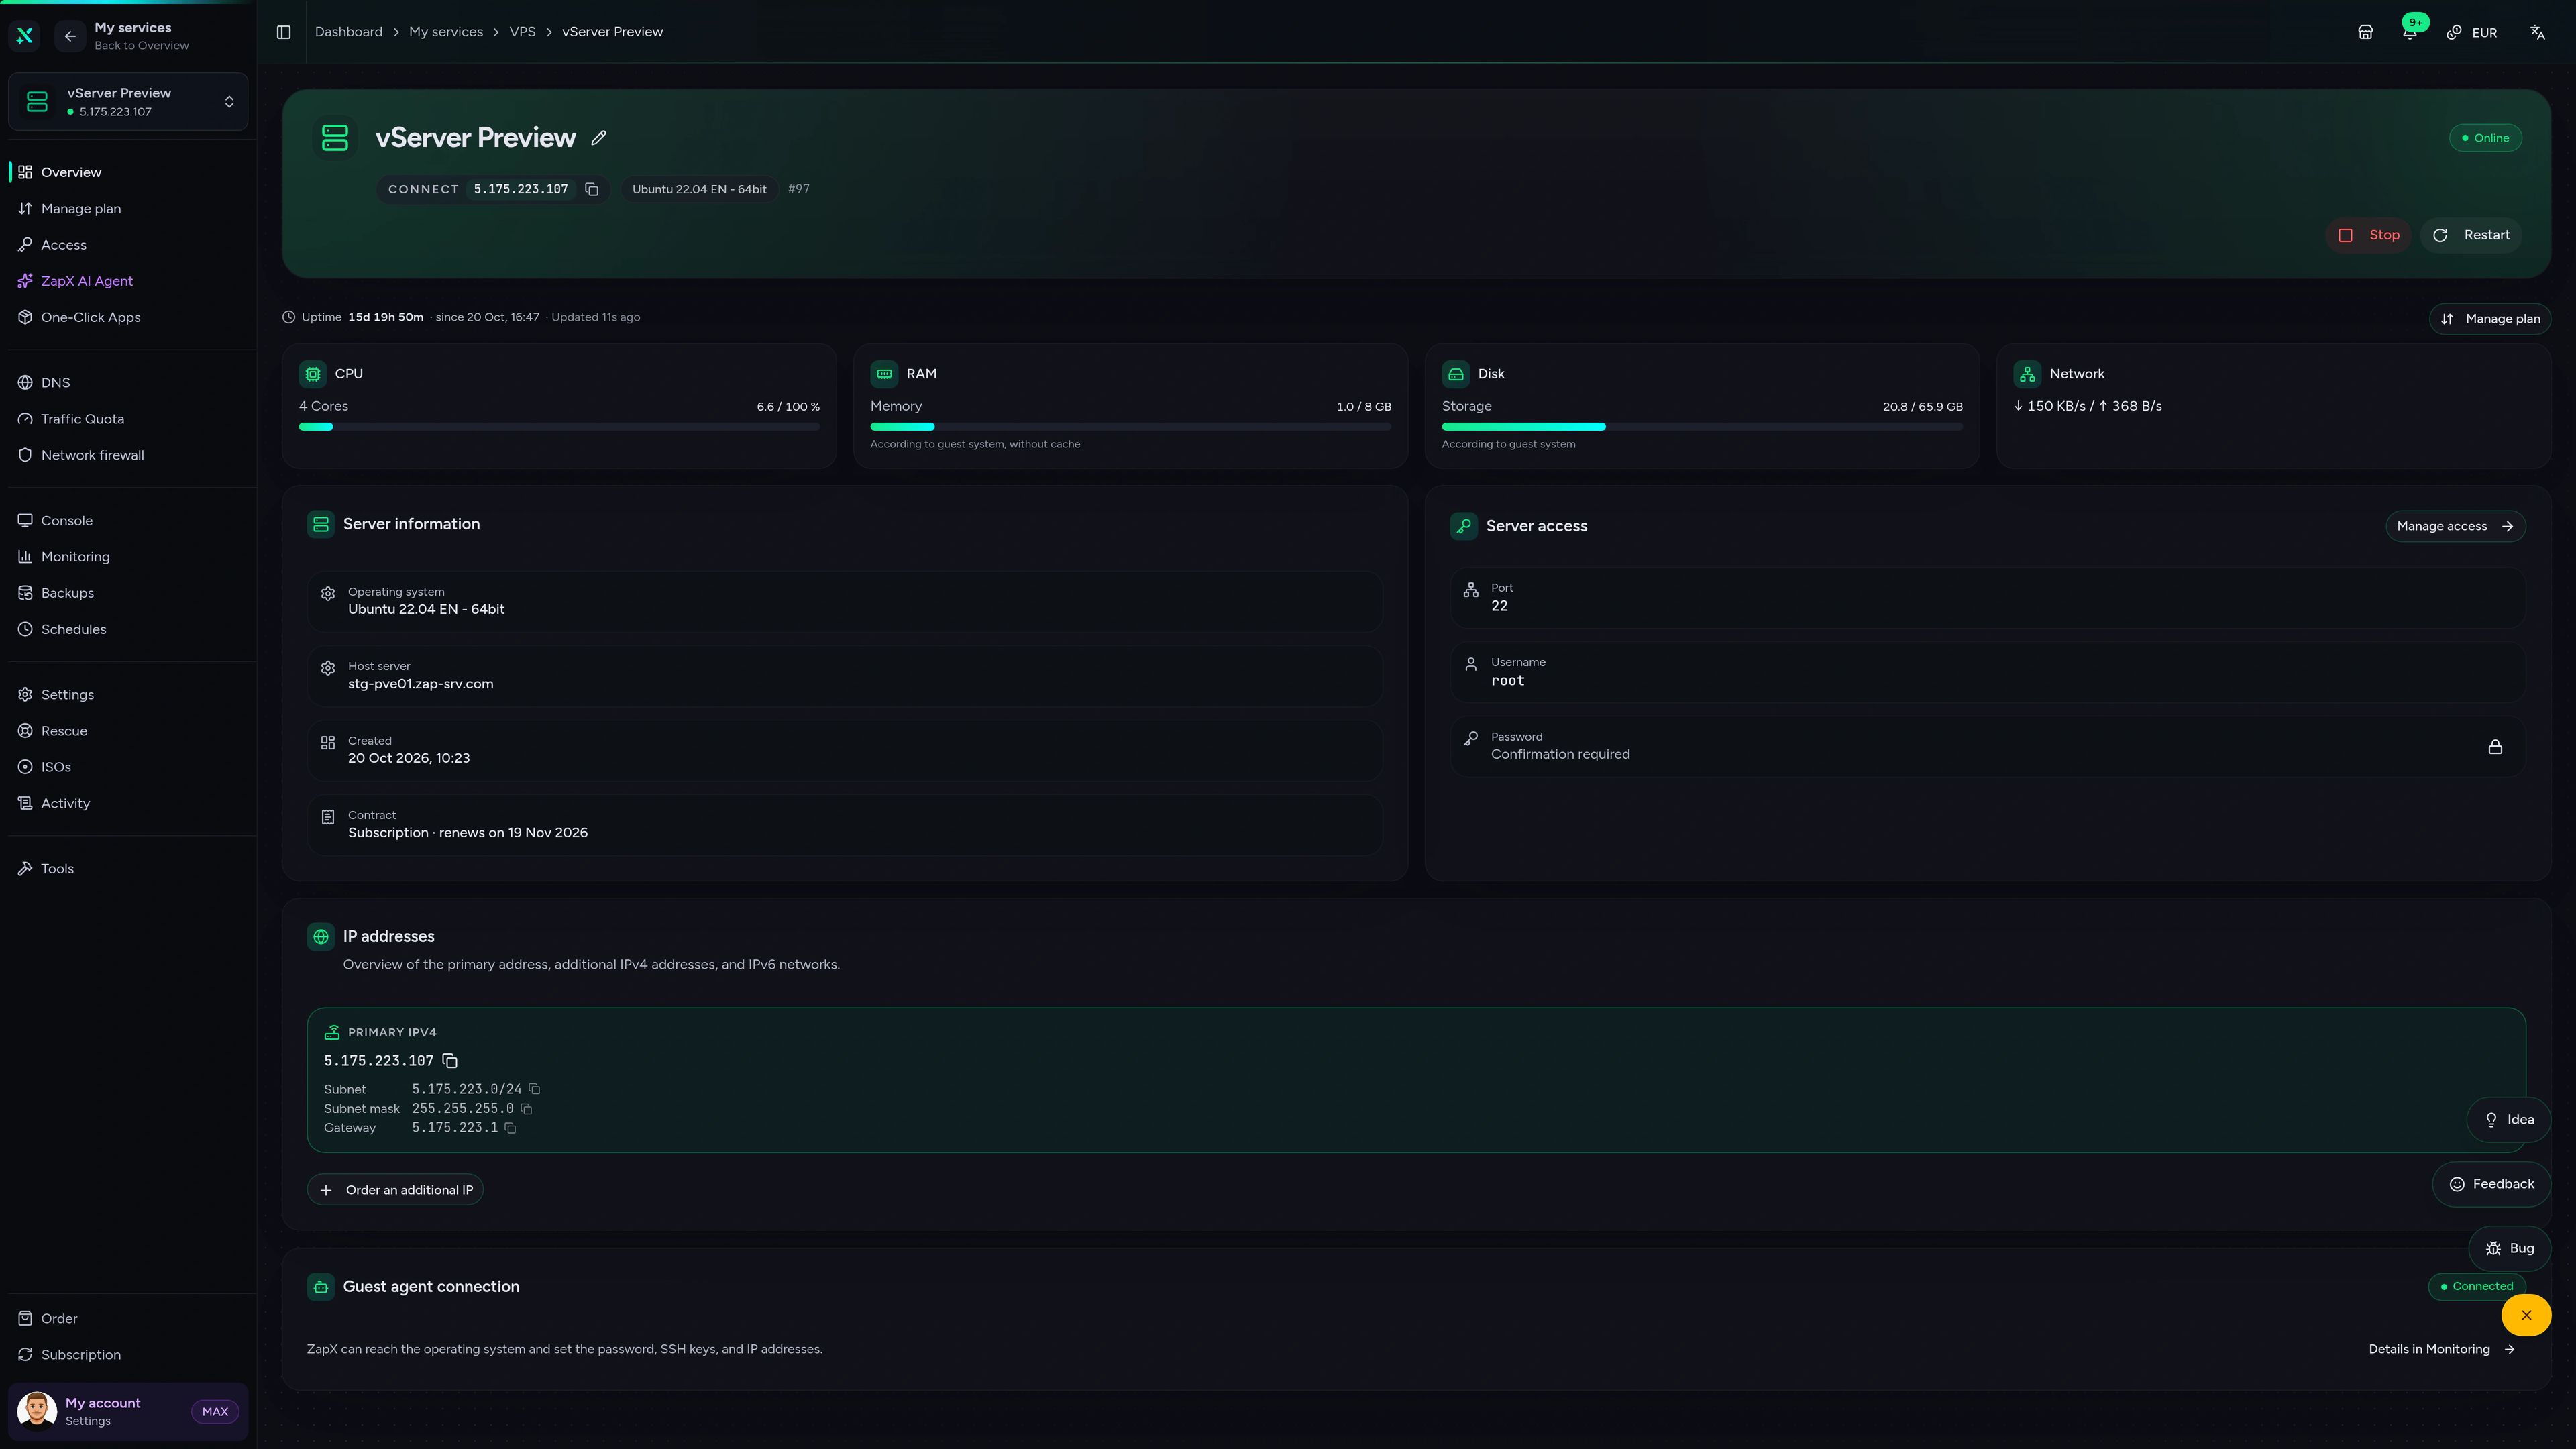
Ressourcen, Firewall, Backups und One-Click Apps an einem Ort: Behalte die Basis deines LiteLLM-Proxys im Blick, während das Gateway für dein Team läuft.
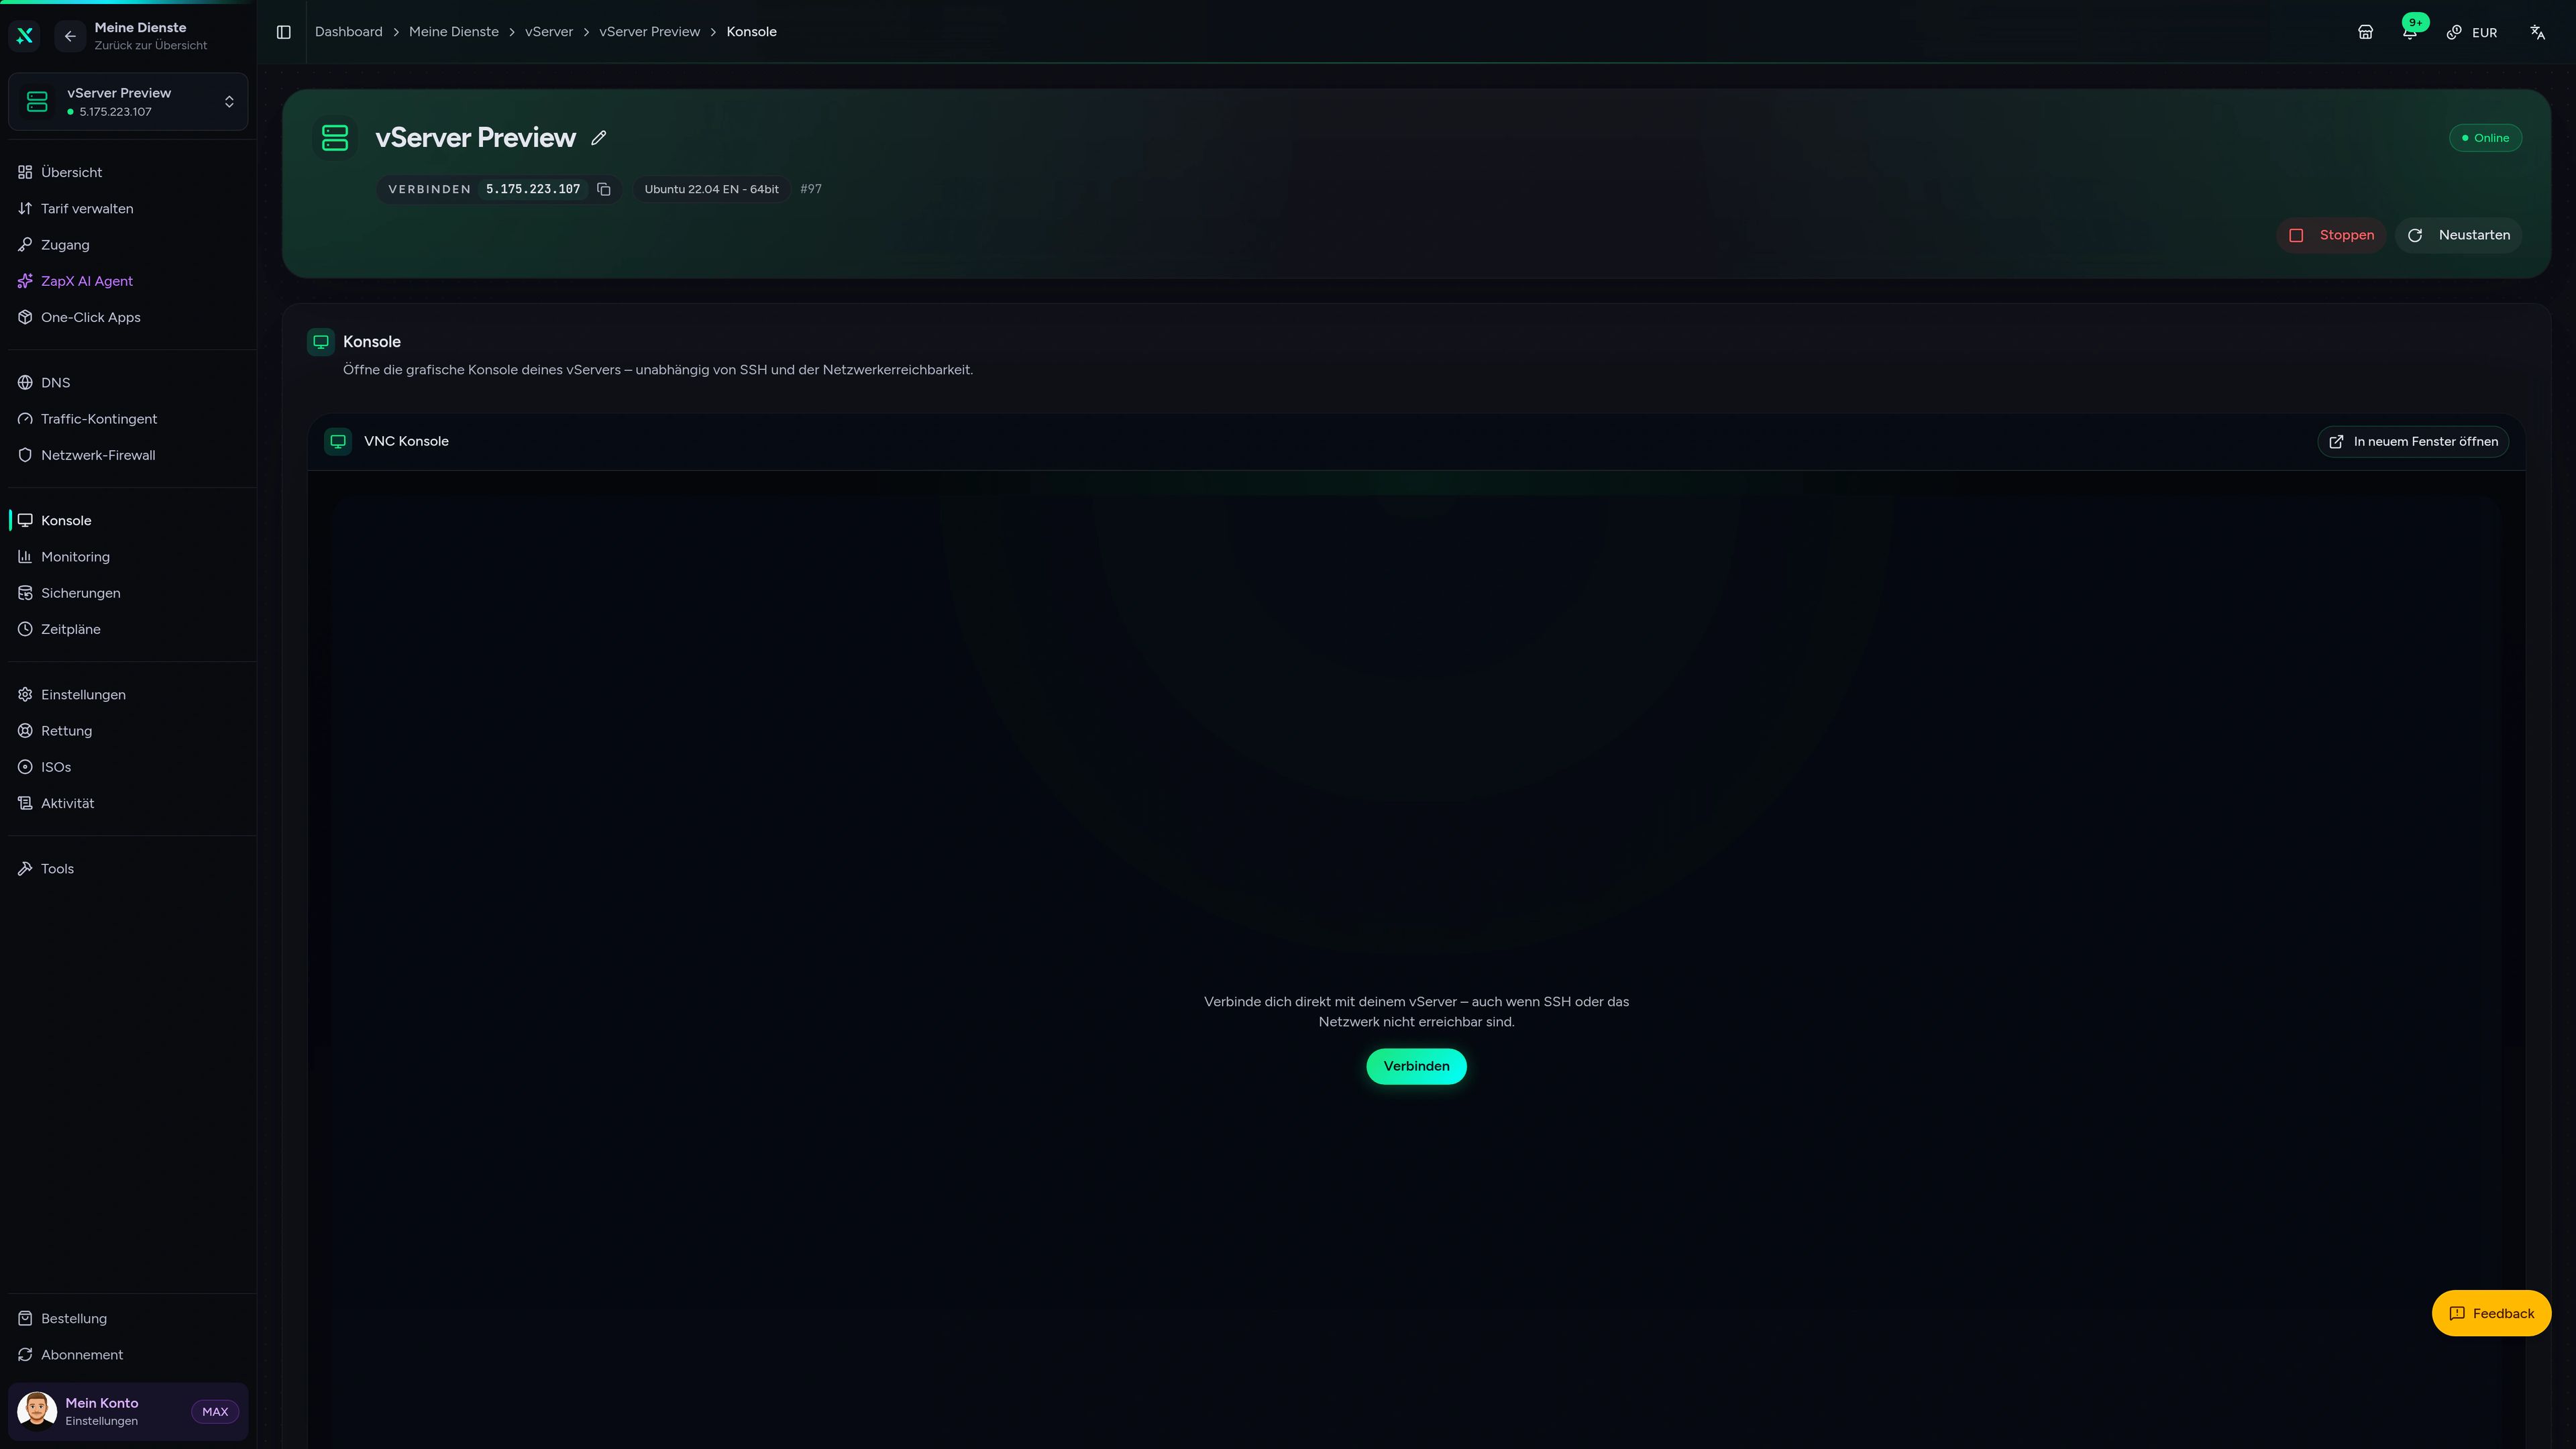
vServer Konsole
VNC-Konsole des vServers im ZapX-Panel
Der ZapX AI Agent kennt den Kontext deines vServers und hilft bei Coolify-Deploys, LiteLLM-Logs, Ressourcen und typischen Startfehlern – direkt im Panel.
Der ZapX AI Agent ist Teil des ZapX Pass und gilt accountweit für alle unterstützten Dienste.
ZapX Pass ansehenZapX AI Agent
panel.zap-hosting.com
Benchmark
Die Plattform blendet hier echte Messwerte ein. Für LiteLLM zählt genug CPU-Reserve, damit der Proxy auch bei vielen parallelen Requests von Coding-Agents nicht bremst.
High-Performance-vServer, CPU-Modell je Standort
Typische vServer-Angebote ohne veröffentlichte Host-CPU
bestätigt 2026-07-01
Konkrete Workloads
Kein generischer vServer, sondern ein AI-Gateway für echte Team-Workloads: Coding-Agents, Chat-Frontends, Automationen und lokale Modelle hinter einer API.
Bereit für dein AI-Gateway?
Starte deinen LiteLLM-Proxy auf eigenem vServer.
Mobile AppComing soon
Prüfe Status und Auslastung deines vServers, starte ihn bei Bedarf neu und behalte die Basis deines LiteLLM-Proxys auch unterwegs im Blick.
Auch verfügbar
WireGuard, Coolify, Monitoring und mehr — One-click auf deinem vServer.
Private Cloud
NextCloud ist eine selbstgehostete, Open-Source-Plattform, die Dateispeicherung, Zusammenarbeit und Kommunikationswerkzeuge für nahtloses Datenmanagement bietet.
Automatische Einrichtung
automation
n8n ist ein erweiterbares Tool zur Automatisierung von Workflows.
Bereit in ~2 Min.
vpn
Die einfachste Möglichkeit, WireGuard VPN + webbasierte Admin-Oberfläche zu betreiben.
Bereit in ~2 Min.
media
Plex organisiert Videos, Musik und Fotos aus persönlichen Mediatheken und streamt sie auf Smart-TVs, Streaming-Boxen und mobile Geräte.
Bereit in ~2 Min.
Passwortsicherheit
Vaultwarden ist ein Passwortmanager, mit dem Sie Ihre Passwörter sicher speichern und verwalten können.
Keine manuelle Konfiguration
cms
WordPress ist eine Open-Source-Software, mit der Sie eine schöne Website, einen Blog oder eine App erstellen können.
Bereit in ~2 Min.
Auch verfügbar
WireGuard, Coolify, Monitoring und mehr — One-click auf deinem vServer.
755
Verfügbare Apps
Vorteil
Der App-Marktplatz gehört zum vServer — ohne Aufpreis pro Installation.
Wähle deine Apps im Konfigurator und starte in Minuten.
Miete deinen vServer, installiere LiteLLM per 1-Klick über Coolify und gib deinem Team einen zentralen API-Key für 100+ KI-Anbieter – ohne GPU.
Kein Setup. Kein Risiko. In 60 Sekunden online.
© 2026 ZAP-Hosting GmbH
 Bevorzugte Quelle bei Google